BACK TO PROJECTS ↗

01 / MACHINE LEARNING & DATA ANALYSIS

CUSTOMER
SEGMENTATION.

PYTHON / K-MEANS / CUSTOMER ANALYTICS

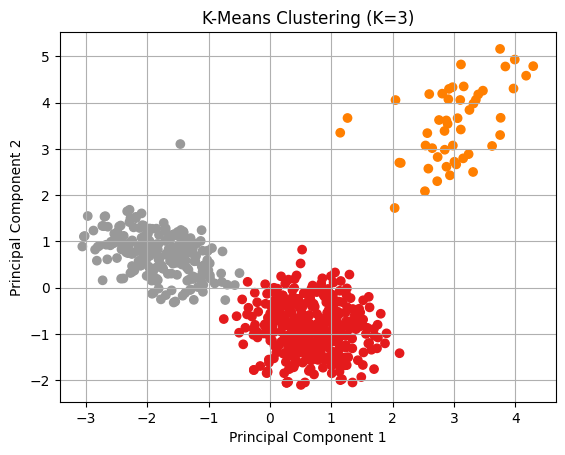
信用卡客戶 K-Means 三群分群視覺化結果

01 / OVERVIEW

PROJECT OVERVIEW

UNDERSTANDING
CUSTOMER BEHAVIOR.

本專案使用 Kaggle 公開資料集 Credit Card Customer Data, 以 660 筆信用卡客戶資料為分析對象,運用 K-Means 非監督式學習方法,依據客戶的信用額度、信用卡數量、 臨櫃往來、線上使用及客服聯繫等數值特徵進行分群, 探索資料中是否存在不同的客戶行為群體。

PROJECT TYPECustomer Segmentation
ALGORITHMK-Means
DATA SOURCEKaggle
DATA SIZE660 Records

02 / OBJECTIVE

PROJECT OBJECTIVE

DISCOVER CUSTOMER
BEHAVIOR GROUPS.

研究問題:不同客戶是否存在明顯的消費與互動行為群體? 本專案希望透過信用額度、信用卡持有數量、臨櫃往來、 線上使用及客服聯繫等特徵,找出具有相似行為模式的客戶群體。

分群前先比較不同 K 值的評估結果,再選定 K=3 進行群體特徵分析,觀察各群客戶在金融往來行為上的差異。

03 / TECHNOLOGY

TOOLS & TECHNOLOGY

PythonPandasScikit-learn K-MeansStandardScalerPCA Elbow MethodSilhouette Score Google Colab

04 / DATASET & PREPROCESSING

PREPARE THE
DATA.

使用 Kaggle 的 Credit Card Customer Data,保留五項客戶數值特徵作為分群依據。 資料前處理與分析步驟依據實際 Notebook 整理如下。

660資料筆數
5分群特徵數
3最終群集數
特徵欄位分析內容
Avg_Credit_Limit平均信用額度
Total_Credit_Cards信用卡總數
Total_visits_bank臨櫃往來次數
Total_visits_online線上使用次數
Total_calls_made客服通話次數
資料處理紀錄

Notebook 中執行缺失值刪除、重複資料檢查與刪除, 移除流水號及客戶識別欄位,並使用 IQR 方法檢視極端值。 最後以 StandardScaler 對五項數值特徵進行 Z-Score 標準化。 Notebook 有進行極端值檢視;此頁不將檢視描述為已刪除極端值。

05 / DEVELOPMENT PROCESS

FROM DATA TO
CLUSTERS.

依照實際 Notebook,整理本次分群分析的主要步驟。

01
DATA COLLECTION

Dataset Collection

從 Kaggle 取得 Credit Card Customer Data,載入 660 筆客戶資料進行分析。

02
DATA PREPROCESSING

Data Cleaning & Scaling

處理缺失值與重複資料、移除識別欄位,選取五項數值特徵並使用 StandardScaler 標準化。

03
CLUSTER EVALUATION

Elbow & Silhouette

比較 K=1 至 10 的 Elbow 曲線,以及 K=2 至 10 的 Silhouette Score,作為分群數量的參考。

04
MODEL TRAINING

K-Means (K=3)

設定 K=3、random_state=42 與 n_init='auto' 執行 K-Means 分群。

05
RESULT ANALYSIS

PCA & Cluster Profiling

使用 PCA 將資料降至兩個主成分以呈現分群分布,並以原始尺度的群中心及群組統計分析客戶特徵。

EVALUATE THE
CLUSTERS.

透過不同評估指標與分群視覺化,檢視模型結果。

01
ELBOW METHOD

肘部法則評估

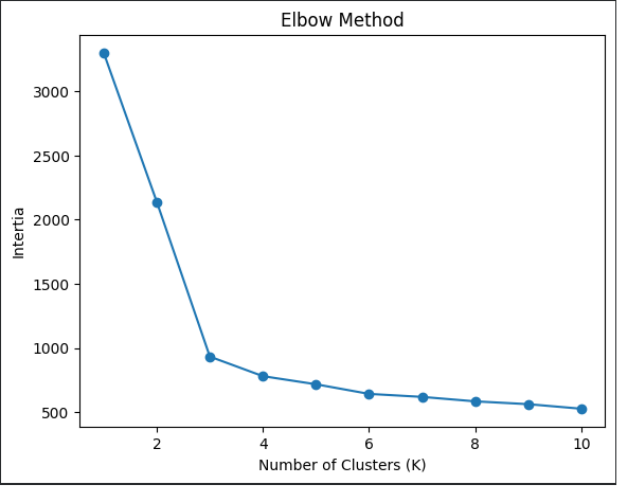
觀察不同 K 值下群內平方和(Inertia)的變化,曲線在 K 約 3 後趨於平緩。
Elbow Method 肘部法則評估圖
Elbow Method — Inertia Evaluation
02
SILHOUETTE SCORE

輪廓係數評估

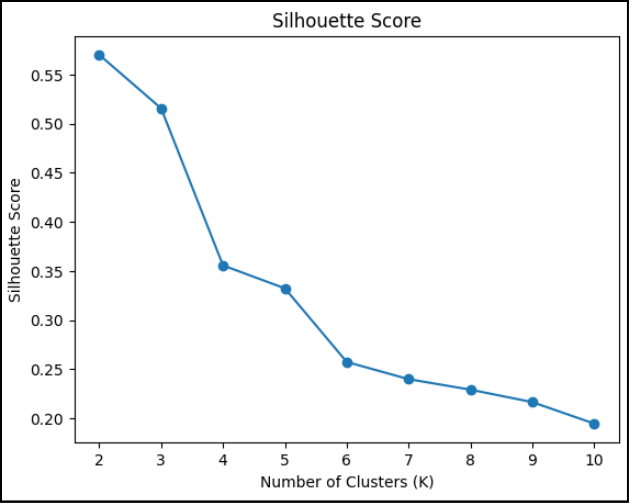
K=2 的輪廓係數最高,K=3 次之,顯示不同評估指標可能產生不同的分群建議。

Silhouette Score 輪廓係數評估圖
Silhouette Score — Cluster Evaluation
03
PCA VISUALIZATION

最終分群結果

使用 PCA 將五項標準化特徵投影至二維空間,呈現 K=3 的三個群集分布。

K-Means K=3 分群結果
K-Means Clustering — K=3
K 值選擇說明

Elbow Method 的曲線在 K 約 3 後下降趨勢趨緩;Silhouette Score 則以 K=2 取得最高值。兩種指標並未一致指向同一個 K 值。本專案後續採用 K=3 進行客戶群體特徵分析,並非宣稱 K=3 在所有評估指標中皆為最佳。

07 / CUSTOMER SEGMENTS

THREE CUSTOMER
PROFILES.

依據 Notebook 的 K=3 分群筆數與反標準化群中心,整理三個群體的主要特徵。

CLUSTER 0 · 386 CUSTOMERS · 58.5%

一般銀行往來型客戶

平均信用額度約 33,782,平均持有 5.52 張信用卡,臨櫃往來次數平均 3.49 次。

CLUSTER 1 · 50 CUSTOMERS · 7.6%

高信用額度活躍型客戶

平均信用額度約 141,040,平均持有 8.74 張信用卡,線上使用次數平均 10.90 次。

CLUSTER 2 · 224 CUSTOMERS · 33.9%

客服依賴型客戶

平均信用額度約 12,174,平均持有 2.41 張信用卡,客服通話次數平均 6.87 次。

群體解讀

群體名稱是依據各群的特徵平均值所做的描述性命名,並非資料集原有標籤。 例如「客服依賴型」是根據該群客服通話次數相對較高而命名, 不代表已證實其客服需求或滿意度。

LEARN THROUGH
ANALYSIS.

從資料處理、模型評估到結果解讀,累積機器學習實作經驗。

01
TECHNICAL LEARNING

技術學習

實作 K-Means,運用 StandardScaler 處理不同尺度的數值特徵,並使用 PCA 進行二維視覺化。

02
MODEL EVALUATION

模型評估

比較 Elbow Method 與 Silhouette Score,理解不同評估指標可能產生不同建議,分群數量需要結合分析目的判斷。

03
DATA INTERPRETATION

資料解讀

透過群中心還原與群組統計,將模型輸出的群集轉換為可理解的客戶特徵描述,練習以數據支持分析結論。